SMALLER TEAM. BIGGER RESULTS.
人が変わっても、
業務品質は、変わらない。
人手不足・異動・離職 — 理由が何であれ、ベテランの手順を対話で引き出し、検証できる業務知として残し、社内のどのAIにも配信します。
生成AIを入れた会社は多い、
業務知が会社に残った会社は、ほとんどない。
AI がどれだけ賢く答えても、その場の会話で終われば、記録には残らない。誰も書き残さなかった。ベテランが辞めたあと、頭の中にしかなかった判断基準は、引き継がれないまま消えていく。
PRESET
答えて終わり、にはしません。
出荷前の検品と同じ厳しさで、会話を記録に変えます。
曖昧な答えは、そのまま通しません。数字や条件が抜けていれば、AI が聞き返します。書き起こすのはあなたではなく、対話そのもの — 話し終えたときには、もう会社に残る記録になっています。
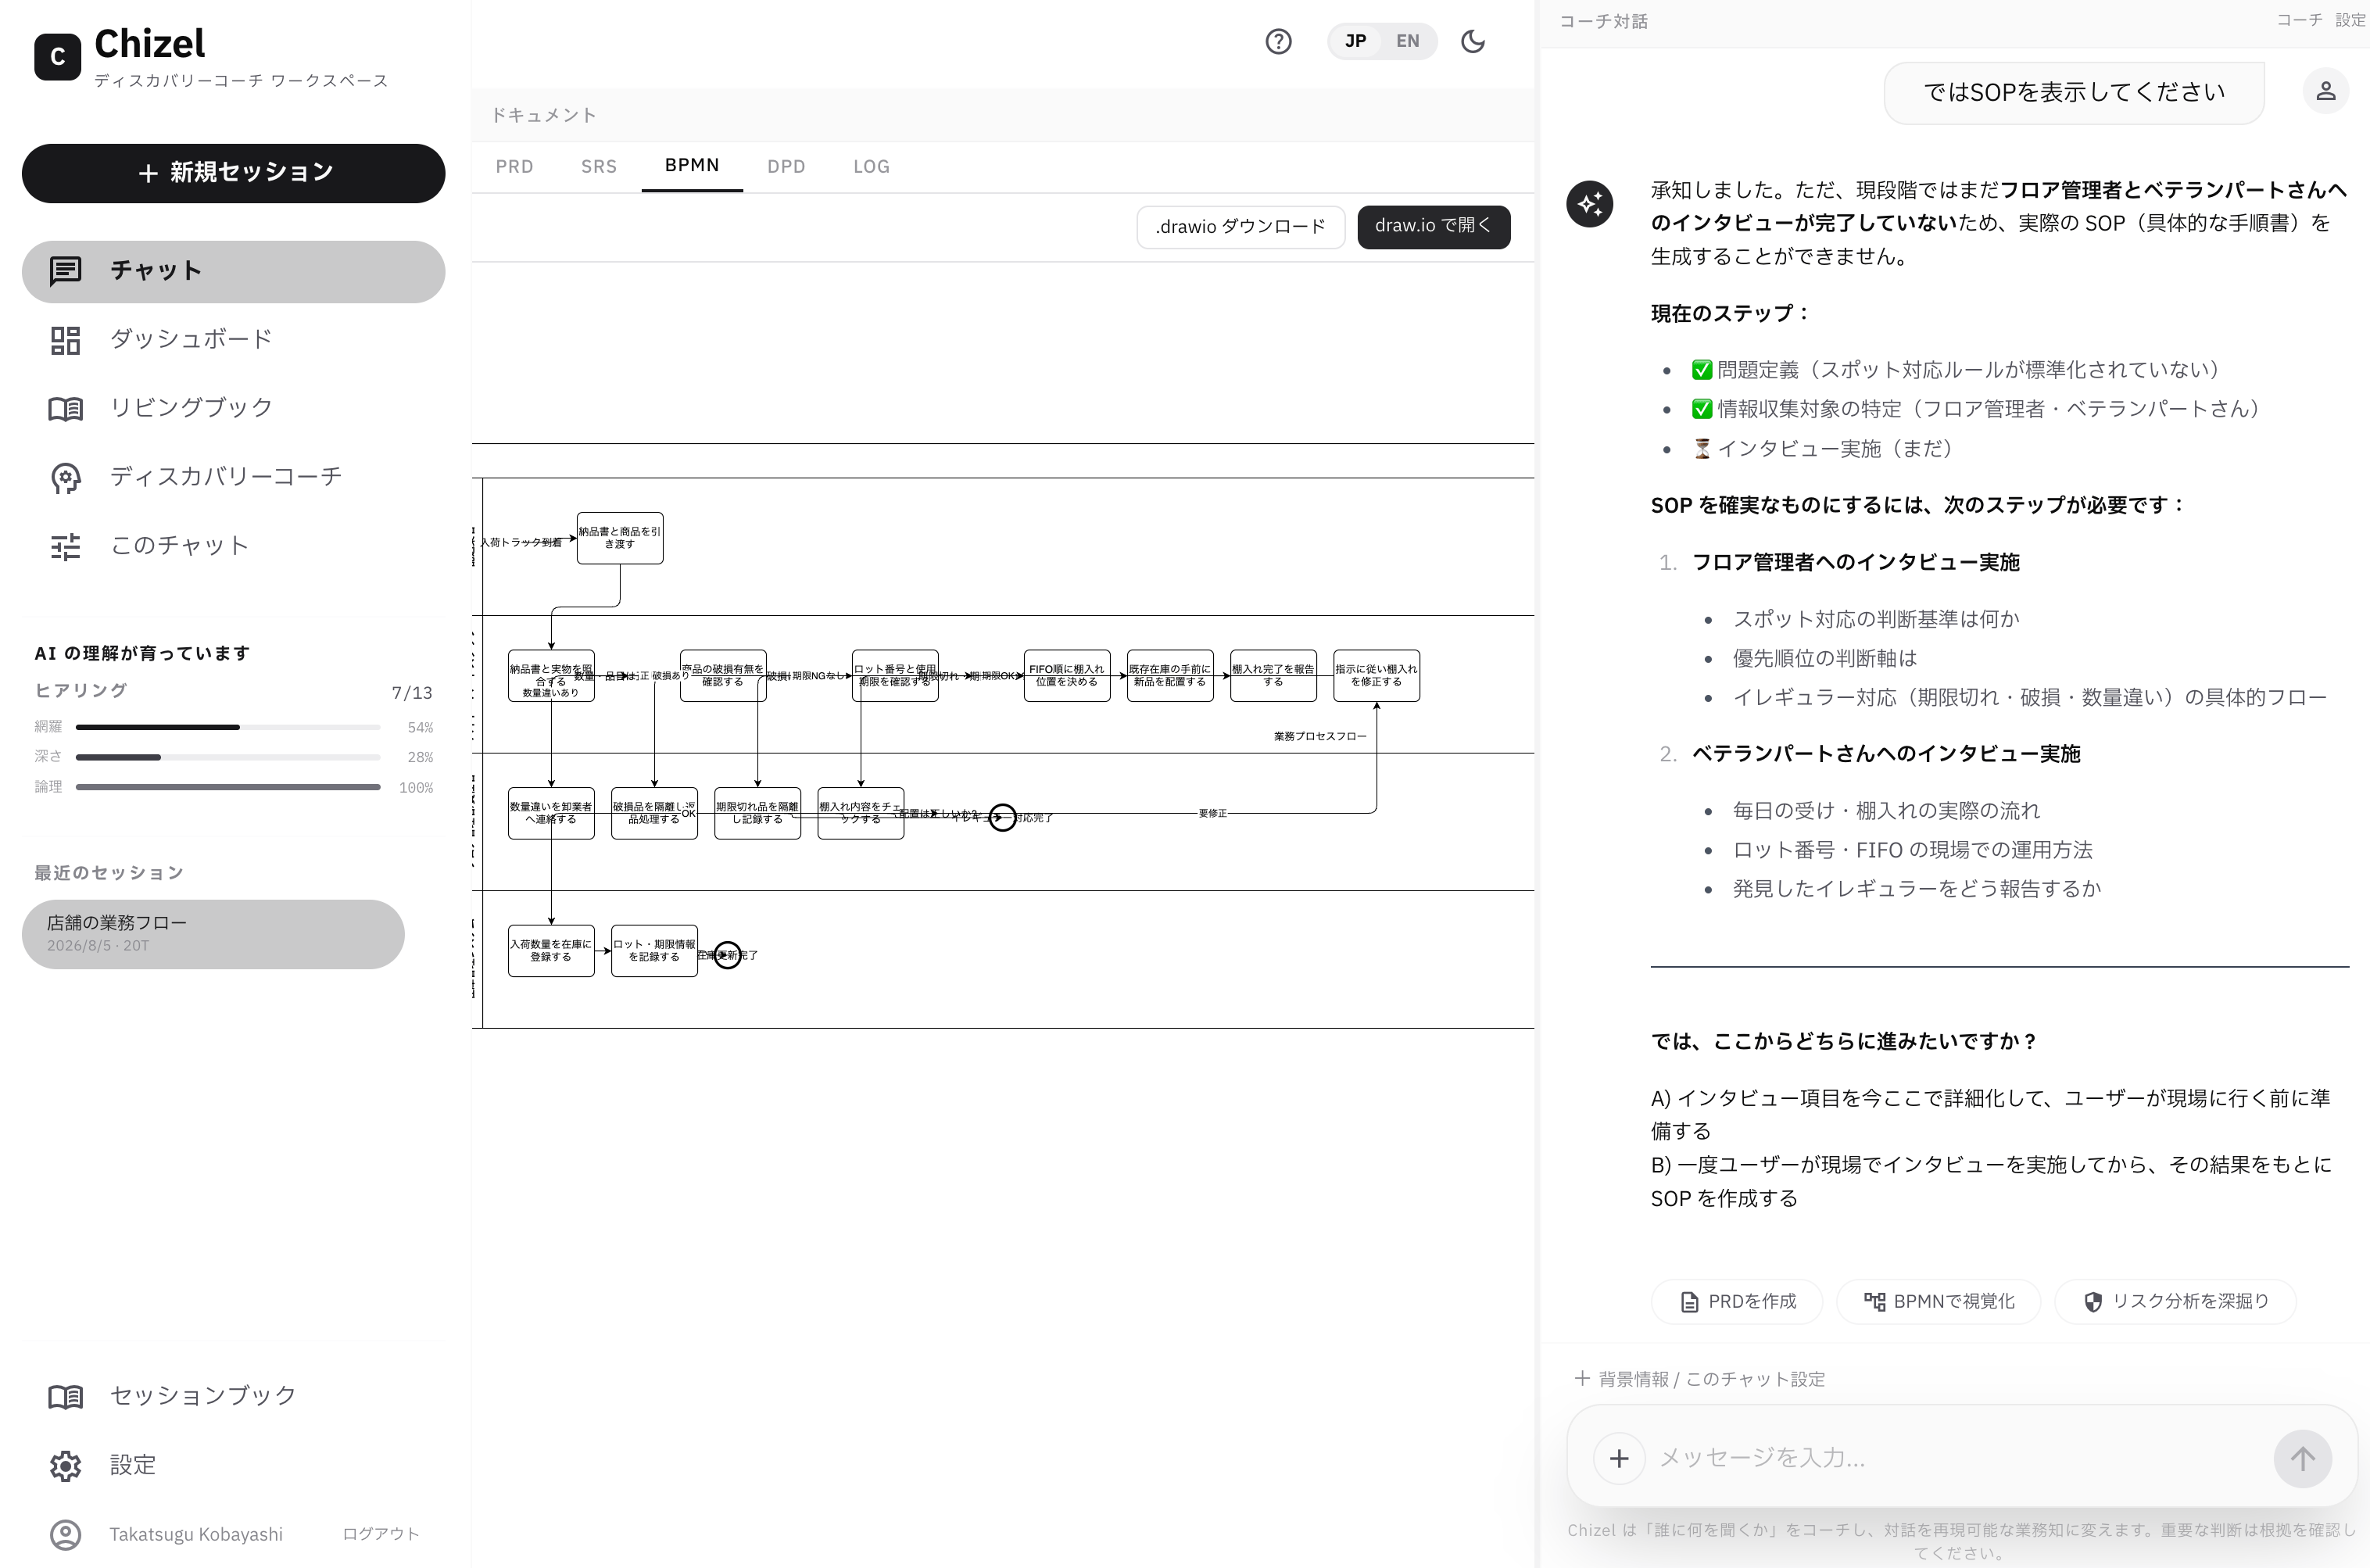
Chizel — ディスカバリーコーチ ワークスペース(実際の画面)
OUTCOMES — 何が変わるか
導入して変わるのは、機能ではなく「その日」。
判断していたその日
白紙の前で固まる月曜が、終わる。
何から手をつければいいか分からず、10分先が見えない。属人化した判断は、半年〜1年でリスクとして表面化する。
なぜ ChatGPT では足りない? — 話は聞いてくれるが、10年選手の暗黙の基準までは知らない。Katalift はその基準を、事前の対話で作っておく。
人が入れ替わる日
ベテランの最終出社日に、頭の中を持ち出される。
退職の最終出社日になって初めて、引き継ぎ資料に判断基準が一つも書かれていないことに気づく。
なぜ防げる? — 対話は日々の業務の中で行われ、退職を待たずに知として残るから。
加速を求められる日
「その AI 判断、根拠は?」に、その場で証跡を出せる。
AI活用を広げるほど、判断の根拠を問われる機会も増える。
なぜ答えられる? — 判定の根拠を、その都度記録しているから。
HOW IT WORKS
3つの層が、会話を業務知に変える。
聞き方を設計する対話
何を聞くべきかを、Katalift 自身が設計します。例外の処理・前提の記録・抜け漏れの検出まで含めて、聞き漏らしません。
検証できる業務知
数値・目的・条件・成果まで含めて、あとから検証できる形で記録します。「なんとなく」を、確認できる形に変えます。
どのAIにも届く
準拠の証明・実行結果・承認の理由まで、社内のどのAIツールにも配信されます。作って終わりにしません。
3つの層は、使うたびに重なっていきます。今日の対話は、これまでに拾った業務知と照らされ、抜けている部分がそのまま次の問いになる。Katalift は知識を溜めるだけの倉庫ではなく、増幅し、意味づけていくエンジンです。
2つの「既にある」との違い
モデルの賢さは借りられる。
規律も、書く人も、借りられない。
vs. 素の AI チャット (Enterprise版含む)
抜け漏れに気づくのは、なぜ?
既存会話の文脈と、その場の判断に依存する。
Katalift事前に設計された判定ルールが、ターンごとに強制する。
誰が使っても同じ深さになるのは、なぜ?
既存Enterprise版でも、質問の設計自体は変わらない。
Katalift深さの基準を仕組みが持つため、誰が使っても揃う。
vs. 既存のSOP・ナレッジ管理ツール
空っぽのまま止まるのは、なぜ?
既存書式はあっても、結局は誰かが座って書かないと埋まらない。
Katalift対話に応じるだけで、書く工程そのものが要らない。
他のAIツールに知を持ち出せないのは、なぜ?
既存そのプラットフォームの中に閉じ、形式も持ち出しにくい。
KataliftJSON/Markdownのオープン形式で書き出され、どのAIにも渡せる。
※ Enterpriseプランが解決するのは共有範囲であって、質問設計や検証の仕組みそのものではありません。
HONESTY
私たちが、言わないこと。
- —文書化の要否を、私たちが代わりに判断するとは言いません。判断するのは、現場の皆さまです。
- —「現場の判断をすべて置き換えます」とは言いません。現場に残すべき判断は、現場に残ります。
- —「導入すれば自動的に精度が上がる」とは言いません。継続的な対話と運用が前提です。